ScrapingAnt — Web Scraping API, Proxies, and AI Extraction in One Stack 已收录进「全球IP代理」分类。网站概述ScrapingAnt 是一个面向现代数据管道与 AI 应用的 Web Scraping API 服务平台,其核心定位是为“构建者”
网站概述
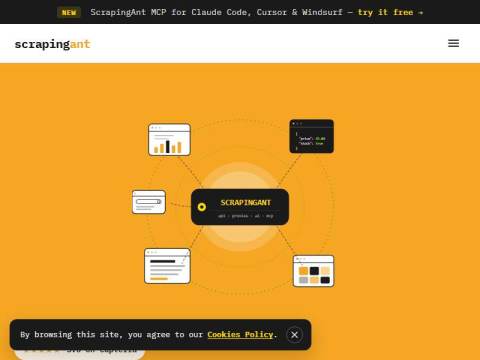
ScrapingAnt 是一个面向现代数据管道与 AI 应用的 Web Scraping API 服务平台,其核心定位是为“构建者”提供一站式解决方案。平台整合了无头 Chrome 浏览器、超过三百万个轮换代理、基于大模型的 AI 智能提取功能,并创新性地提供了托管的 MCP(Model Context Protocol)服务器,让 AI 智能体能够直接通过标准协议调用抓取能力。与传统的单一抓取 API 不同,ScrapingAnt 强调“一个积分池、一个 API Key”的简洁理念,用户无需为代理、浏览器、提取等不同功能分别购买服务或管理多个密钥,所有操作都通过统一接口完成,极大降低了集成复杂度和费用管理成本。
核心功能与服务
- 无头 Chrome 浏览器渲染:ScrapingAnt 使用真实的 Chrome 浏览器实例来加载网页,完美支持 JavaScript 渲染、CSS 动画、Ajax 请求等动态内容,能够模拟真实用户浏览行为,从而获取完全渲染后的页面源代码。用户可以通过参数设置屏幕尺寸、启用心智(如 Disable GPU)、设置等待时间等。
- 百万级轮换代理池:平台拥有超过三百万个不同地区的高质量代理 IP,自动进行轮换,有效规避 IP 封禁与访问限制。代理商提供国家/城市级别的定向,适合需要访问特定区域内容的场景,如对比不同国家的电商价格或搜索地区性新闻。
- AI 智能提取功能:基于大语言模型(LLM)的提取能力允许用户用自然语言描述需要的数据结构,例如“提取所有文章标题和作者”,ScrapingAnt 会自动解析页面内容并返回结构化的 JSON 数据,免去了编写 CSS/XPath 选择器的繁琐步骤。
- 托管 MCP 服务器:针对 AI Agent 应用,ScrapingAnt 提供托管 MCP 服务器,这意味着任何支持 MCP 协议的 AI 框架(如 LangChain、AutoGPT 等)都可以通过标准化接口调用 ScrapingAnt 的抓取与提取能力,使 AI 能够实时获取外部知识,增强其数据处理和推理能力。
- 统一积分与账户管理:用户只需购买一次积分,所有功能(包括代理使用、浏览器渲染、AI 提取请求)都会从同一个积分池中扣除,且仅需一个 API Key 即可访问所有功能,让费用跟踪与权限管理变得清晰简单。
- 实时日志与监控:平台提供详细的请求日志,包括状态码、响应时间、代理 IP 信息、渲染耗时等。用户可以在仪表盘中实时查看任务执行状态,并设置错误报警。
适用人群与典型场景
- AI 开发者与智能体开发者:对于正在构建基于 RAG(检索增强生成)的应用或自主智能体的开发者,ScrapingAnt 的 MCP 服务器和 AI 提取功能可以直接嵌入到工作流中,让 AI 在几秒内获取并理解网页数据,极大提升系统实时性。
- 数据分析师与市场研究机构:需要从多个来源聚合数据以进行市场趋势分析、竞品洞察或消费者情绪监测,ScrapingAnt 的代理池和渲染能力能稳定支持大规模数据采集。
- 电商与零售行业:用于价格监测、库存跟踪、产品评论收集等,尤其适合需要访问多个国家站点的跨境电商团队,因为地理定向功能可以帮助获取本地化价格数据。
- 媒体和新闻聚合服务:快速采集新闻文章、视频信息、社交媒体内容等,并通过 AI 提取关键实体,为内容推荐或舆情系统提供数据燃料。
- 无代码/低代码爱好者:ScrapingAnt 的 AI 提取功能让不懂代码的业务人员也能通过自然语言描述即可从网站中抽出所需字段,降低了数据采集的门槛。
特色优势
- AI 原生设计:ScrapingAnt 从底层就为 AI 时代设计,AI 提取并非仅仅是附加功能,而是与代理、渲染深度融合,用户甚至可以用对话的方式指定提取规则,大大减少了传统抓取中的“选择器调试”工作。
- 极高的稳定性和容错:百万级 IP 池及智能调度算法保证了高可用性,自动重试机制在意外失败时会自动重新请求,确保任务完成。
- 极低的入门门槛:不仅提供包括 Python、Node.js 等常见语言的 SDK,还提供了基于浏览器的可视化构建工具,用户可以在线配置抓取任务并直接生成代码。
- 灵活的计费方式:积分制并用一体化的模式避免了多项服务叠加带来的成本不确定性,同时提供免费试用额度,让用户无需付费即可评估服务质量。
- 全面的合规支持:ScrapingAnt 致力于帮助用户遵守目标网站的服务条款,并提供如自定义 User-Agent、设置请求频率限制等工具,以降低对源网站的负面影响。
局限或注意事项
- AI 提取的准确性依赖模型:尽管大模型能够理解自然语言,但在处理复杂页面或非标准布局时可能出错,这时仍需手动编写选择器作为备用方案。AI 提取适合快速原型开发,但对于生产环境的高精度要求,建议结合校验机制。
- 大量请求的成本控制:虽然积分制统一计费,但高强度的抓取任务(如百万级页面)仍可能产生显著费用,因此建议合理规划缓存机制和抓取频率。
- 网站反爬措施的持续升级:没有任何服务能保证 100% 绕过所有反爬机制,尤其是一些高度防护的网站(如大型社交平台),但 ScrapingAnt 的持续更新通常能快速适应。
- 对网络依赖:作为云服务,用户的本地网络稳定性不会影响抓取,但 ScrapingAnt 自身的服务可用性可能受云提供商维护或攻击影响,因此关键任务应关注其状态页面。
- 法律边界:用户必须确保抓取内容不侵犯版权、个人隐私或违反所在司法管辖区法律,ScrapingAnt 强调其服务仅用于合法用途,并对滥用行为保留终止服务的权利。
如何开始使用
开始使用 ScrapingAnt 非常简单。首先,前往官网注册账号,完成邮箱验证后,系统会提供一个 API Key 和一定量的免费体验积分。登录后,在 Dashboard 中可以看到清晰的请求测试区域,可以输入一个网址,选择是否渲染 JavaScript,并设置需要的输出格式(HTML 或 JSON)。如果希望使用 AI 提取,可以在“提取模式”下用英文或中文描述目标字段,平台会返回示例数据。接下来,你可以在文档中心找到针对各种语言的“快速开始”指南,例如 Python 中只需几行代码发送 GET 请求,附上参数和 API Key 即可。对于 AI 应用,ScrapingAnt 提供了 MCP 服务端地址,你可以将它配置到你的 AI Agent 框架中,从而让 AI 动态调用抓取工具。此外,平台还提供了 Webhook 回调功能,可以使任务完成后自动将结果推送到你的服务器,适合异步批处理。无论你的技术背景如何,ScrapingAnt 都致力于用最短的时间让你完成从注册到第一次成功抓取的整个过程。
数据统计
数据评估
关于ScrapingAnt — Web Scraping API, Proxies, and AI Extraction in One Stack特别声明
本站168跨境导航网提供的ScrapingAnt — Web Scraping API, Proxies, and AI Extraction in One Stack都来源于网络,不保证外部链接的准确性和完整性,同时,对于该外部链接的指向,不由168跨境导航网实际控制,在2026年8月14日 上午11:35收录时,该网页上的内容,都属于合规合法,后期网页的内容如出现违规,可以直接联系网站管理员进行删除,168跨境导航网不承担任何责任。
相关导航

紫鸟超级浏览器专注解决TikTok Shop、亚马逊、沃尔玛、eBay、Shopee等跨境电商账号安全管理问题,为Amazon、Wish、eBay、独立站等跨境电商卖家提供专业安全的店铺管理方案,专业技术让店铺安全更简单。
Global Proxy IP Solutions|Enterprise-Grade Proxy Networks Empowering AI Data Col
9HTTP delivers enterprise proxy IP solutions with 90M+ real IPs across 200+ countries, supporting AI data collection and cross-border business. Register

Crawlera
Crawlera

牛卖防关联指纹浏览器
牛卖防关联浏览器用八年技术沉淀,为跨境卖家打造一款安全稳定的超级浏览器,支持亚马逊,Amazon,Tiktok,eBay,Shopee,Lazada等所有平台及独立站,多用户多店铺操作

Scrape Any Website with AI & Proxies | MrScraper
Web scraping API with built-in proxies, headless browsers, and AI. Extract data from any website at scale - fast, reliable, and hassle-free.

Redirecting…
Redirecting...

MyIP
MyIP

Bright Data – All in One Platform for Proxies and Web Scraping
Award winning proxy networks, powerful web scrapers, and ready-to-use datasets for download. Welcome to the world's #1 web data platform.
暂无评论...